Når ingen kan stole på data, starter arbejdet forfra

I de fleste organisationer er der data nok. Usikkerheden handler om, hvilke data man skal bruge. Det koster timer på hver opgave, møder om hvem der har ret, og beslutninger truffet på et tal, ingen kunne efterprøve. Indtil nu har medarbejderne selv dækket hullet, men en AI-agent gør det ikke. Et datakatalog samler de oplysninger, der mangler, og det virker først, når oplysningerne er aktuelle og har en ejer.

Situationer, I sikkert kan genkende

Det ligner fire forskellige problemer. Årsagen er den samme. Data findes. Det er oplysningerne om data, der mangler: betydning, ejer, kvalitet, friskhed og tilladt anvendelse.

Forretningsmæssigt betaler I for det tre gange. Analytikere og forretningsbrugere bruger en del af hver opgave på at finde ud af, om et datasæt kan bruges. Nye medarbejdere er længe om at blive produktive, fordi viden om data sidder i hovedet på kollegaer. Og en beslutning bliver truffet på et tal, ingen kunne efterprøve, hvilket først viser sig, når den er ført ud i livet. Alle tre kan måles. Det er dem, effekten skal vise sig på.

Indtil nu har en medarbejder dækket hullet

Oplysningerne om data (metadata) findes i tre lag med hver sin ejer. Hvad begrebet betyder. Hvordan det er implementeret teknisk. Og hvordan data faktisk opfører sig: sidste opdatering, frekvens, kvalitetsmålinger og livscyklus. Det sidste lag afgør, om et datasæt kan bruges, og det er også det, vi oftest ser mangler.

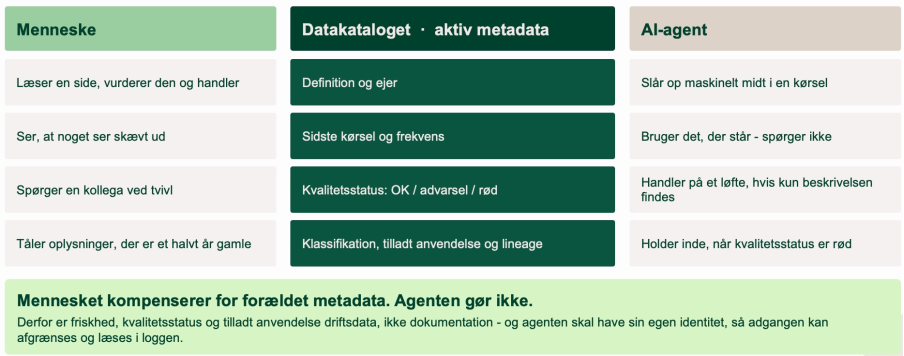
Et klassisk katalog er bygget til mennesker: en side, en medarbejder læser, vurderer og handler på. Hun tåler gamle oplysninger, fordi hun kompenserer: hun ser, at noget ser skævt ud, og spørger en kollega.
En agent kompenserer ikke. Den bruger, hvad der er tilgængeligt, når den kører. Læser den "opdateres dagligt" i en beskrivelse, handler den på et løfte. Læser den faktisk sidste kørsel og kvalitetsstatus, handler den på en kendsgerning og kan holde inde, når status er rød. Det er forskellen mellem en agent, der leverer et forkert svar hurtigt, og en agent, der siger, at grundlaget ikke er godt nok i dag.

Genereres oplysningerne automatisk, for eksempel tidsstempel for seneste kørsel, klassifikation ved ingest og brugssignaler fra driften, holder de sig selv opdaterede. En beskrivelse fortæller, hvordan data så ud, dengang nogen skrev om dem. En måling fortæller, hvordan de ser ud nu.

Skal AI-løsninger i drift, er det her, forudsætningen ligger, og det er en af de billigste forudsætninger at etablere.


5 Data Governance Artikel

Fire spørgsmål, datakataloget skal kunne svare på

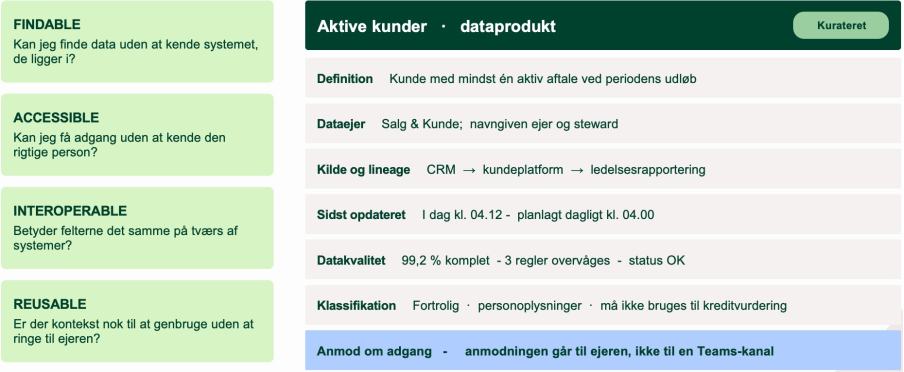
Et datakatalog skal kunne svare på fire ting om et datasæt:

  1. Hvem ejer det?

  2. Hvad betyder det?

  3. Hvor friskt er det?

  4. Hvad må det bruges til?

Kan det ikke det, bliver hvert dataspørgsmål et lille efterforskningsarbejde.

De fire spørgsmål udmønter ideerne bag FAIR-principperne (findable, accessible, interoperable, reusable) som felter i kataloget. Værdien opstår, når en bruger kan søge på et forretningsbegreb i stedet for et tabelnavn og få ejer, definition, frekvens, kvalitetsstatus og tilladt anvendelse ét sted. Adgang bestilles i kataloget frem for i en tråd på Teams, og anmodningen går til den, der faktisk må godkende.


6 Data Governance Artikel 

Uden katalog gives adgang på systemniveau og bliver enten for bred eller for langsom. Står klassifikation, ejer og tilladt anvendelse på det enkelte datasæt, kan både en medarbejder og en agent få adgang til præcis det, opgaven kræver, og personoplysninger maskeres.

For compliance er gevinsten, at dokumentationen findes i forvejen. Klassifikation, ejerskab og lineage bliver et biprodukt af drift, og en del af det, der skal kunne fremvises omkring et højrisikosystem, er allerede skrevet ned.

Hvem står på mål for oplysningerne

Kataloget er stedet, oplysningerne kan slås op. Det siger ikke noget om, hvem der har lovet, at de holder.

Det gør datastandarden og datakontrakten: to aftaler, der holder løftet. Standarden binder begrebet frem for systemet: skifter I CRM ud, står definitionen af kunde stadig, sammen med ejerskab og hvem der er afhængig af den. Kontrakten gør de samme oplysninger maskinlæsbare, så de rejser med dataene: definition, ejer, kilde, kvalitetskrav, opdateringsfrekvens og tilladt anvendelse. Det er de felter, kataloget viser, og som producenten er forpligtet på.

Det betaler sig, når data krydser en organisatorisk grænse, når flere forbrugere afhænger af samme definition, og når en AI-løsning læser data uden et menneske imellem. Tag ét dataområde ad gangen. En kontrakt, der beskrives, men aldrig tjekkes, er stadig et dokument.

To fælder, der får kataloger til at fejle

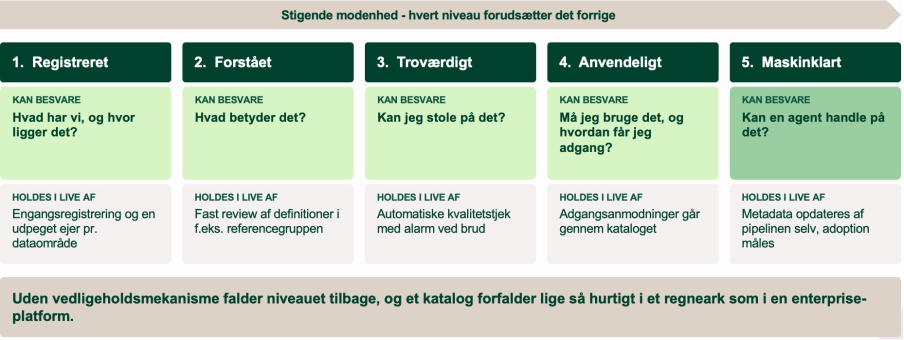
Modenheden afgør, hvad kataloget kan bruges til

7 Data Governance Artikel 

Modenhed handler om, hvad kataloget kan svare på, og hvad der holder svarene opdaterede. Uden vedligeholdsmekanisme forfalder et katalog lige så hurtigt i et regneark som i en enterprise-platform. Vælg niveauet efter, hvad I kan holde i live, og lad behovet bestemme værktøjet frem for licensen.

Skal en agent handle på data, er det øverste niveaukrav. Et katalog, hvor datasæt kun er registreret, viser navn og placering. Det mangler ejer, definition og kvalitetsstatus. Det er værd at afklare, før en AI-løsning bliver planlagt oven på et katalog på det niveau.

Adoption skal måles

Kataloget er det governance-artefakt, hvis værdi helt afhænger af frivillig brug. En politik gælder, selvom ingen læser den; et katalog holder op med at virke, og forfaldet er tavst.

Antal registrerede dataassets måler travlhed. Det, der måler værdi, er:

Går et af tallene den gale vej, er årsagen sjældent teknisk. Den er, at ingen har tid eller mandat til at kuratere, og det er en ledelsesbeslutning.

Start, hvor det gør mest ondt

Katalogisér ikke alt. Vi har set kataloger med flere tusinde registrerede datasæt, hvor kun en brøkdel har en ejer. Et mindre antal datasæt med ejer, definition, kvalitet og friskhed er mere brugbare end alle dem tilsammen.

Start der, hvor behovet er nu: et rapporteringsspor, der brænder, et compliance-krav med en dato, eller en AI-løsning, der skal i drift. Det giver en ejer, der har en grund til at holde oplysningerne opdaterede, og det er den eneste ting, der holder et katalog i live.

Effekten viser sig på de tre omkostninger fra situationsafsnittet: tiden per opgave, tiden før en ny medarbejder kan arbejde selvstændigt med data, og antallet af beslutninger truffet på et tal, ingen kan efterprøve. Alle tre kan følges, længe før kataloget er færdigt, og de bevæger sig først på de dataområder, I starter med.

Vi hjælper jer med at afgøre, hvilke dataområder kataloget skal starte med, og hvad minimumsoplysningerne skal være hos jer. Et første forløb er kort: en dækningsmåling på de kilder, I tror er med, et minimumssæt af oplysninger aftalt med de ejere, der skal vedligeholde dem, og ét dataområde, der er registreret og i brug.
Vil du høre mere?

Kontakt
Honey Arora Senior Manager

+45 2989 7209

har@immeo.dk

HAR
breaker